
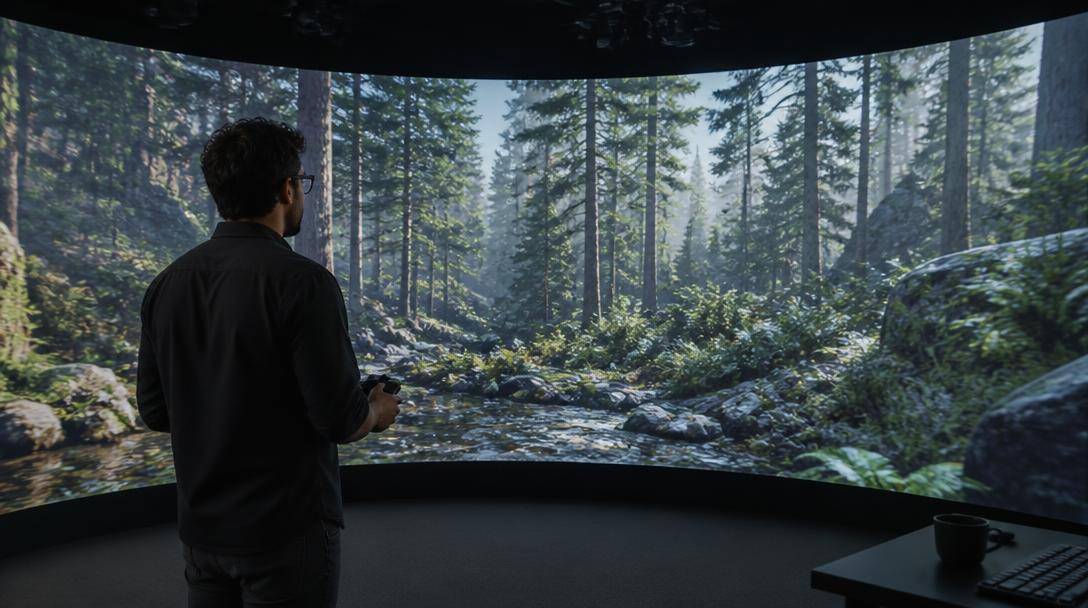
Google DeepMind ha presentato il 27 ottobre 2026 Genie 4, un modello di intelligenza artificiale capace di generare ambienti virtuali esplorabili in tempo reale, modificarli attraverso istruzioni in linguaggio naturale e riprodurre suoni e conversazioni coerenti con le scene. La nuova tecnologia amplia le possibilità dei cosiddetti world model, sistemi progettati per simulare il comportamento di un ambiente e le conseguenze delle azioni compiute al suo interno.
La novità interessa direttamente lo sviluppo dei videogiochi, la produzione audiovisiva e la progettazione di simulazioni utilizzabili nella robotica. A differenza dei tradizionali generatori di immagini e video, Genie 4 Google permette di intervenire sull’ambiente mentre viene generato, modificando condizioni atmosferiche, movimenti della telecamera, oggetti e personaggi senza dover ricostruire ogni volta la scena dall’inizio.
Il sistema è stato presentato attraverso dimostrazioni che mostrano paesaggi fotorealistici, interazioni tra personaggi, fenomeni fisici e ambienti fantastici. La disponibilità, tuttavia, rimane inizialmente circoscritta a un gruppo selezionato di sperimentatori. L’accesso per gli abbonati Google AI Ultra e per alcuni sviluppatori arriverà successivamente, attraverso Project Genie e gli strumenti dedicati alle applicazioni basate sull’intelligenza artificiale.
Come funziona un world model e cosa cambia rispetto ai video generati dall’AI
Un world model è un sistema che apprende a rappresentare il funzionamento di un ambiente, prevedendo come questo possa evolvere nel tempo e reagire a determinate azioni. Nel caso di Genie 4, l’obiettivo consiste nel costruire una simulazione audiovisiva che continui a svilupparsi mentre l’utilizzatore esplora lo spazio virtuale o impartisce nuove istruzioni.
La differenza rispetto alla generazione video tradizionale riguarda soprattutto il controllo della sequenza. Un video prodotto attraverso un prompt presenta generalmente una successione di immagini già determinata durante la generazione. In un ambiente interattivo, invece, il sistema deve rispondere continuamente alle decisioni dell’utilizzatore, mantenendo una relazione plausibile tra ciò che è accaduto e quanto viene visualizzato successivamente.
Il percorso di ricerca di Google DeepMind su questa tecnologia è iniziato prima dell’ultimo annuncio. Nel febbraio 2024 il laboratorio aveva presentato il primo Genie, un sistema addestrato anche attraverso filmati disponibili online, senza richiedere necessariamente informazioni esplicite sui comandi che avevano prodotto le azioni osservate.
Con Genie 3, annunciato nell’agosto 2025, la ricerca aveva raggiunto un livello di interattività superiore. Il modello poteva generare ambienti navigabili in tempo reale a una risoluzione di 720p e 24 fotogrammi al secondo, mantenendo una relativa coerenza per sessioni di durata limitata.
Genie 4 prosegue questo sviluppo introducendo una maggiore fedeltà visiva, movimenti umani più naturali e una gestione più articolata degli eventi. La componente audiovisiva viene inoltre integrata nella generazione dell’ambiente, anziché essere trattata esclusivamente come un contenuto separato.
Non significa che il sistema costruisca necessariamente un mondo tridimensionale secondo le modalità di un motore grafico tradizionale. La simulazione viene prodotta attraverso modelli generativi che elaborano la rappresentazione visiva e sonora della scena, prevedendone l’evoluzione in risposta agli input ricevuti.
Questa distinzione è decisiva per comprendere le opportunità della tecnologia, ma anche i suoi limiti attuali.
Ambienti modificabili in tempo reale attraverso il linguaggio naturale
Una delle caratteristiche centrali di Genie 4 Google è la possibilità di modificare una simulazione già avviata utilizzando semplici istruzioni testuali.
Nelle dimostrazioni pubblicate da DeepMind, gli ambienti possono essere esplorati attraverso i normali comandi da tastiera, mentre indicazioni in linguaggio naturale permettono di intervenire sulla scena. Il sistema può cambiare il tempo atmosferico, spostare il punto di osservazione oppure introdurre persone e oggetti.
Il risultato dipende dalla capacità del modello di interpretare il nuovo comando senza perdere completamente la continuità con quanto già generato.
In una delle dimostrazioni viene rappresentata una piattaforma sospesa sopra un lago, con vegetazione, un elemento luminoso e un musicista che suona il sassofono. La scena combina movimenti della telecamera, condizioni di luce, dettagli ambientali e suoni coerenti con la situazione rappresentata.
Altre prove mostrano paesaggi ghiacciati osservati da una mongolfiera, ambienti naturali attraversati da materiali in movimento e situazioni popolate da numerosi personaggi.
La generazione interattiva richiede che il sistema mantenga una rappresentazione sufficientemente stabile degli elementi della scena. Se viene introdotto un nuovo oggetto, per esempio, questo dovrebbe conservare una posizione e un comportamento riconoscibili mentre cambia la prospettiva.
Per affrontare il problema, Google utilizza anche modelli della famiglia Gemini. Gemini Omni contribuisce alla rappresentazione dell’aspetto e del comportamento degli ambienti, mentre altri modelli intervengono nell’organizzazione degli eventi e nel mantenimento della continuità.
In particolare, Gemini 3.8 Flash opera come agente di coordinamento: osserva i fotogrammi prodotti, suddivide gli obiettivi in passaggi successivi e verifica l’avanzamento della simulazione. Quando cambiano le condizioni o interviene un nuovo comando, il modello può adattare la sequenza delle azioni previste.
L’integrazione tra generazione audiovisiva e ragionamento costituisce uno degli aspetti più interessanti del progetto, perché permette di affrontare situazioni nelle quali la semplice produzione di immagini non sarebbe sufficiente.
Suoni ambientali, musica e dialoghi generati insieme alle immagini
L’audio rappresenta una delle novità più evidenti rispetto alle precedenti generazioni di Genie. Il nuovo modello produce direttamente suoni associati agli ambienti simulati, includendo rumori naturali, musica e conversazioni tra personaggi.
La generazione sonora avviene durante lo sviluppo della scena. In un ambiente marino possono comparire il rumore delle onde e del vento, mentre il movimento di un personaggio o l’interazione con un oggetto possono accompagnarsi a effetti sonori pertinenti.
Google DeepMind ha mostrato anche ambienti fantastici, come una corsa tra draghi osservata dalla prospettiva di un cavaliere, nella quale il modello riproduce rumori del vento, battiti d’ali e altri elementi acustici associati all’azione.
Un ulteriore elemento riguarda i dialoghi interattivi, che possono adattarsi agli eventi e agli input ricevuti durante la simulazione. I personaggi non devono quindi limitarsi a ripetere una conversazione interamente predisposta prima dell’avvio dell’esperienza.
Per i videogiochi, questa capacità potrebbe contribuire allo sviluppo di personaggi virtuali con comportamenti meno rigidamente programmati. La possibilità di sostenere conversazioni dinamiche, tuttavia, non equivale ancora alla disponibilità di personaggi dotati di memoria persistente, personalità stabile e capacità narrativa affidabile per sessioni prolungate.
Anche l’accuratezza dei suoni resta un problema tecnico aperto. La presenza di audio generato insieme alle immagini non garantisce che ogni evento abbia una corrispondenza acustica perfetta, soprattutto quando la scena comprende numerose interazioni simultanee.
Videogiochi: dalla descrizione testuale ai prototipi esplorabili
Il settore videoludico è uno dei possibili ambiti applicativi di Genie 4 Google, soprattutto nelle fasi iniziali della progettazione.
Un ambiente virtuale tradizionale richiede normalmente la costruzione di scenari, materiali, animazioni, sistemi di illuminazione e comportamenti interattivi attraverso strumenti dedicati. I motori grafici consentono un controllo dettagliato di questi elementi, ma la preparazione di un prototipo può richiedere lavoro specialistico e tempi significativi.
Un modello generativo interattivo permette invece di sperimentare rapidamente idee visive e comportamentali attraverso descrizioni testuali.
Un gruppo di sviluppo potrebbe, per esempio, valutare diverse atmosfere per un ambiente di gioco, verificare l’effetto di condizioni meteorologiche differenti oppure esplorare possibili interazioni tra personaggi e scenario. Si tratta di applicazioni progettuali, non di funzionalità già dimostrate come sostitutive dell’intero processo di sviluppo.
DeepMind riferisce che sviluppatori di videogiochi e professionisti delle tecnologie creative stanno sperimentando il passaggio da un’idea iniziale a un prototipo navigabile, valutando stili visivi, materiali e meccaniche interattive attraverso il linguaggio naturale.
L’interesse principale riguarda la velocità con cui una proposta può essere visualizzata e modificata prima di investire risorse nella produzione.
Occorre però distinguere un prototipo esplorabile da un videogioco completo. Un prodotto commerciale richiede sistemi di progressione, gestione delle regole, salvataggi, interfacce, prestazioni prevedibili e meccaniche che devono funzionare in maniera coerente anche dopo numerose ore di utilizzo.
Non è stato dimostrato che Genie 4 possa garantire autonomamente tutte queste caratteristiche.
Le capacità attuali risultano quindi particolarmente pertinenti alla preproduzione, alla sperimentazione creativa e alla valutazione delle idee. L’eventuale integrazione nei processi industriali dovrà tenere conto anche dei costi di elaborazione, della controllabilità dei risultati e della possibilità di trasferire quanto generato nei sistemi di sviluppo già utilizzati dagli studi.
Simulazioni fisiche e robotica: il ruolo del ragionamento di Gemini
Le applicazioni prospettate per Genie 4 Google comprendono anche contesti nei quali la qualità grafica ha un’importanza secondaria rispetto alla capacità di riprodurre comportamenti plausibili.
Nella ricerca robotica, gli ambienti simulati vengono utilizzati per sperimentare azioni e strategie prima di trasferirle su dispositivi fisici. Un robot può essere esposto virtualmente a situazioni differenti, riducendo la necessità di riprodurre ogni scenario direttamente nel mondo reale.
Il valore di queste simulazioni dipende però dalla precisione con cui vengono rappresentati movimenti, collisioni, proprietà degli oggetti e relazioni di causa ed effetto.
DeepMind ha illustrato alcune prove dedicate alla simulazione di fenomeni fisici e movimenti umani, includendo interazioni con oggetti, comportamenti aerodinamici e scene con numerosi individui.
Le dimostrazioni mostrano progressi nella resa visiva di questi fenomeni, ma non costituiscono da sole una validazione scientifica della precisione fisica del modello. Un comportamento convincente sullo schermo potrebbe non corrispondere a quello effettivamente osservabile in condizioni reali.
Particolarmente significativa è la sperimentazione che combina Genie 4 con Gemini 4 Argon e le attività di ricerca di Gemini Robotics.
In una prova, i modelli collaborano alla simulazione di un robot umanoide Apollo di Apptronik impegnato in una partita a dama. Gemini 4 Argon suddivide il compito in passaggi, che vengono utilizzati per orientare la simulazione mentre questa viene generata.
Il procedimento permette di collegare la pianificazione delle azioni alla rappresentazione dinamica dell’ambiente.
L’approccio potrebbe risultare utile per testare sequenze operative complesse, individuare errori di pianificazione e osservare come un agente reagisce al cambiamento delle condizioni. Resta però necessario verificare se quanto appreso in un ambiente generato possa essere trasferito con sufficiente affidabilità a un robot reale.
Un sistema destinato alla formazione di agenti autonomi, infatti, deve riprodurre con precisione anche eventi poco frequenti, errori meccanici e situazioni impreviste. La credibilità visiva rappresenta soltanto una parte del problema.
Dalla produzione cinematografica alla ricostruzione di ambienti storici
Le possibili applicazioni si estendono alla produzione audiovisiva e alla visualizzazione di scenari difficili da realizzare fisicamente.
Nel cinema, una simulazione interattiva può essere impiegata durante la progettazione delle inquadrature o nella definizione dell’aspetto di una sequenza. La possibilità di spostare la telecamera e modificare l’ambiente durante l’esplorazione offre strumenti differenti rispetto alla generazione di singole immagini statiche.
La tecnologia potrebbe contribuire alla preparazione di storyboard dinamici e alla valutazione delle scelte scenografiche. Le prime sperimentazioni condotte con professionisti creativi si concentrano proprio su queste attività preliminari, nelle quali la rapidità delle modifiche può avere un valore concreto.
Un altro campo riguarda la ricostruzione esplorabile di ambienti storici. DeepMind sta valutando la possibilità di utilizzare mondi popolati e dinamici per rappresentare luoghi del passato e consentire esperienze di osservazione più coinvolgenti.
Un impiego del genere richiederebbe comunque un controllo rigoroso delle informazioni storiche. La capacità di produrre un ambiente plausibile non garantisce che edifici, abiti, oggetti e comportamenti corrispondano alle evidenze documentarie.
Sono inoltre allo studio simulazioni relative a eventi ambientali di breve durata, come incendi e alluvioni improvvise. In questi ambiti, la differenza tra visualizzazione illustrativa e simulazione scientificamente attendibile è particolarmente rilevante.
Per diventare strumenti utilizzabili nella valutazione dei rischi, i modelli dovrebbero essere confrontati con dati osservativi e simulazioni fisiche validate. Senza queste verifiche, il loro impiego rimane più appropriato alla rappresentazione di scenari ipotetici che alla previsione operativa degli eventi.
I limiti attuali: continuità degli oggetti, precisione spaziale e durata
Le dimostrazioni di Genie 4 Google evidenziano risultati promettenti, ma la tecnologia presenta ancora diverse limitazioni.
Una delle principali riguarda la permanenza degli oggetti, cioè la capacità di mantenere riconoscibili posizione, aspetto e caratteristiche degli elementi mentre cambia il punto di osservazione o si sviluppano nuovi eventi.
Durante una simulazione prolungata possono verificarsi alterazioni dei dettagli visivi, trasformazioni inattese degli oggetti e incoerenze nella disposizione dello spazio. Il rischio aumenta quando vengono introdotte numerose modifiche attraverso prompt successivi.
La difficoltà deriva dalla necessità di mantenere una rappresentazione coerente di un ambiente che continua a essere generato. Nei motori grafici tradizionali gli oggetti possiedono normalmente proprietà e coordinate definite. Nei modelli generativi, invece, la continuità deve essere mantenuta attraverso processi di previsione che possono accumulare errori.
Rimangono inoltre aperte questioni relative alle interazioni fisiche complesse, alla rappresentazione accurata delle distanze e alla leggibilità del testo presente nelle scene.
Secondo le informazioni raccolte da TechCrunch in occasione della presentazione, le esperienze possono mantenere una relativa coerenza per circa due minuti, rispetto al limite di circa un minuto del precedente prototipo interattivo. Il dato non va interpretato come garanzia di stabilità assoluta per tutta la durata della simulazione.
Queste limitazioni spiegano perché i risultati mostrati non possano ancora essere equiparati a un ambiente virtuale controllabile e persistente senza restrizioni temporali.
Le dimostrazioni pubblicate costituiscono esempi selezionati delle capacità del modello. Al momento dell’annuncio non risultano disponibili valutazioni indipendenti sufficienti per stabilire in modo completo l’affidabilità del sistema nelle diverse condizioni d’impiego.
Quando sarà disponibile Genie 4 e chi potrà utilizzarlo
La presentazione del 27 ottobre 2026 non coincide con un lancio generalizzato.
Genie 4 è disponibile inizialmente come anteprima di ricerca per un gruppo limitato di tester selezionati. Google prevede successivamente di estendere l’accesso agli abbonati Google AI Ultra attraverso Project Genie e ad alcuni partner di sviluppo tramite Gemini API e Google AI Studio.
Project Genie esiste già come ambiente sperimentale per la creazione e l’esplorazione di mondi virtuali. Introdotto al pubblico nel gennaio 2026, inizialmente negli Stati Uniti, è stato sviluppato per consentire agli utilizzatori di generare e modificare ambienti interattivi a partire da istruzioni testuali e immagini.
La disponibilità di Project Genie non implica però che tutti i suoi utilizzatori abbiano già accesso alla quarta generazione del modello. Il passaggio a Genie 4 è previsto attraverso una distribuzione successiva, con criteri e tempistiche ancora da definire completamente.
Google ha predisposto una lista d’attesa per gli interessati alla nuova tecnologia. Non sono stati comunicati un calendario definitivo di distribuzione generale né un listino specifico per l’utilizzo di Genie 4 attraverso le API.
Rimane inoltre da chiarire quali funzionalità saranno effettivamente disponibili nelle diverse modalità di accesso, soprattutto per quanto riguarda la durata delle esperienze, il numero di generazioni e la gestione degli ambienti creati.
La distribuzione limitata permette anche di raccogliere informazioni sul comportamento del modello e sui possibili utilizzi impropri.
DeepMind ha annunciato l’impiego di sistemi di sicurezza e l’inserimento di SynthID nei contenuti audiovisivi generati. La tecnologia introduce una marcatura digitale impercettibile, progettata per facilitare l’identificazione di materiale prodotto dall’intelligenza artificiale.
La gestione dell’origine dei contenuti assume particolare rilevanza quando i mondi sintetici raggiungono un livello di realismo tale da rendere difficile distinguere una registrazione autentica da una scena interamente generata.
Per gli sviluppatori, la fase di accesso anticipato sarà soprattutto un’occasione per verificare caratteristiche che i filmati dimostrativi non possono misurare completamente: stabilità durante interazioni ripetute, latenza dei comandi, riproducibilità delle scene e possibilità di integrare gli ambienti generati in applicazioni più articolate.
Sono questi elementi, insieme alla precisione delle simulazioni e alle condizioni economiche di utilizzo, che determineranno quanto rapidamente la tecnologia potrà passare dalla sperimentazione a strumenti effettivamente impiegabili nella produzione di videogiochi e nei sistemi di simulazione professionale.
